Автор: Денис Аветисян
Исследователи предлагают метод ‘пессимистической верификации’, нацеленный на выявление ошибок в рассуждениях больших языковых моделей при решении математических задач.

Представлены простые и масштабируемые методы верификации, ориентированные на поиск ложных отрицательных результатов в математических доказательствах, используя новый бенчмарк QiuZhen-Bench.
Несмотря на успехи больших языковых моделей в решении математических задач, надежность их решений остается критической проблемой. В работе «Pessimistic Verification for Open Ended Math Questions» предложен подход, основанный на “пессимистической верификации”, направленный на повышение точности обнаружения ошибок в доказательствах, путем параллельного проведения нескольких независимых проверок. Показано, что данная стратегия, не требующая значительных вычислительных ресурсов, существенно улучшает результаты на стандартных бенчмарках, превосходя даже расширенные методы CoT по эффективности. Не является ли данный подход ключом к созданию более надежных и эффективных систем для решения сложных математических задач, открывающих путь к долгосрочным вычислениям?
Ловушка Иллюзий: Почему БЯМ Так Легко Обмануть
Несмотря на впечатляющие возможности, большие языковые модели (БЯМ) по-прежнему подвержены ошибкам при решении сложных задач, требующих логического мышления и анализа. Эти модели, обученные на огромных объемах текстовых данных, способны генерировать связные и правдоподобные ответы, однако зачастую не способны отличить истину от лжи, особенно в ситуациях, требующих понимания контекста или применения здравого смысла. Ошибки могут проявляться в виде фактических неточностей, логических противоречий или неспособности корректно решать математические задачи, что подчеркивает необходимость разработки методов повышения надежности и точности БЯМ при решении задач, требующих глубокого понимания и рассуждений.
Традиционные методы верификации, основанные на достижении консенсуса, оказываются неэффективными при оценке ответов больших языковых моделей (LLM). Особенность LLM заключается в способности генерировать сложные и многогранные тексты, что делает определение «правильного» ответа затруднительным даже для экспертов. Простое сравнение нескольких сгенерированных вариантов или привлечение большого количества оценщиков не гарантирует надежности, поскольку нюансы в рассуждениях могут быть упущены, а субъективные интерпретации — преобладать. Масштаб генерируемого LLM контента также создает логистические трудности: проверка каждого ответа вручную становится непосильной задачей. Таким образом, потребность в новых подходах к верификации, способных учитывать сложность и объем LLM-выводов, становится все более очевидной.
В связи с возрастающей сложностью задач, решаемых большими языковыми моделями (БЯМ), акцент в обеспечении их надёжности смещается от поиска согласия между различными моделями к активному выявлению ошибок. Традиционные методы верификации, основанные на достижении консенсуса, оказываются неэффективными в масштабах и с учётом тонкостей, характерных для работы БЯМ. Вместо того, чтобы стремиться к единогласному ответу, современные исследования направлены на разработку алгоритмов, способных точно и быстро идентифицировать потенциальные сбои и несоответствия в логике рассуждений модели. Такой подход позволяет не только повысить доверие к результатам, но и предоставляет возможность для более эффективного обучения и совершенствования БЯМ, направленного на минимизацию ошибок и повышение общей надёжности системы.

Пессимистическая Верификация: Новый Взгляд на Надёжность БЯМ
Пессимистическая верификация представляет собой отличный от традиционного подхода к оценке больших языковых моделей (LLM), делая акцент на выявлении ошибок, а не на достижении консенсуса между оценщиками. В отличие от методов, стремящихся к согласию, данный подход предполагает, что даже единичное обнаружение ошибки является критичным сигналом о потенциальной ненадёжности модели. Это означает, что оценка считается неудачной, если хотя бы один из рецензентов указывает на неточность или логическую ошибку в ответе модели, независимо от того, согласны ли другие рецензенты с этим заключением. Такой подход позволяет более эффективно выявлять слабые места в рассуждениях LLM и повышает надежность оценки, особенно при решении сложных задач.
Метод пессимистической верификации включает в себя ряд ключевых техник, среди которых простая верификация (Simple Verification) и вертикальная верификация (Vertical Verification). Простая верификация предполагает маркировку ответа как ошибочного, если хотя бы один из рецензентов указывает на ошибку, что обеспечивает высокую чувствительность к потенциальным проблемам. Вертикальная верификация, в свою очередь, направлена на повышение масштабируемости процесса оценки за счет параллельного проведения рецензирования несколькими независимыми группами, что позволяет обрабатывать большее количество задач и снижать общее время оценки.
Комбинирование методов пессимистической верификации, таких как простая и вертикальная верификация, направлено на создание надежной системы выявления потенциальных ошибок в логических рассуждениях больших языковых моделей (LLM). Простая верификация, требующая единогласного подтверждения от всех рецензентов, в сочетании с вертикальной верификацией, позволяющей распараллеливать процесс оценки, обеспечивает масштабируемость и повышает эффективность обнаружения сбоев в рассуждениях LLM даже при увеличении сложности решаемых задач. Такой подход позволяет не просто оценивать общую производительность модели, но и целенаправленно выявлять слабые места и потенциальные источники ошибок в ее логике.
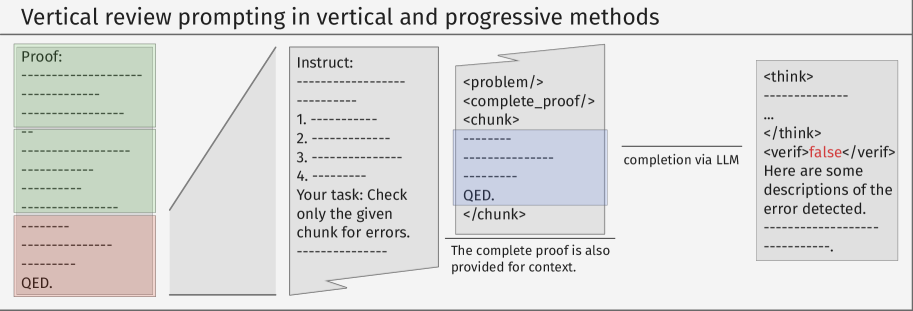
Прогрессивная Верификация: Оптимизация Производительности и Масштабируемости
Прогрессивное подтверждение (Progressive Verification) развивает подходы простого (Simple Verification) и вертикального (Vertical Verification) подтверждения, предлагая более эффективное и масштабируемое решение для оценки больших языковых моделей (LLM). В отличие от последовательного применения методов, прогрессивное подтверждение комбинирует их стратегически, позволяя одновременно использовать преимущества параллельной обработки и повышать точность выявления ошибок. Это достигается за счет адаптивного распределения проверок, что снижает вычислительные затраты и позволяет оценивать модели на больших наборах данных с сохранением высокой скорости и надежности результатов.
Прогрессивное верификация объединяет подходы простой и вертикальной верификации, что позволяет добиться повышения эффективности обнаружения ошибок без потери преимуществ параллельной обработки. Данная стратегия заключается в последовательном применении методов верификации, начиная с быстрых и легко масштабируемых (простая верификация), и постепенно переходя к более точным, но ресурсоемким (вертикальная верификация). Такой подход позволяет снизить общую вычислительную нагрузку по сравнению с последовательным применением только вертикальной верификации, сохраняя при этом высокий уровень точности выявления ошибок за счет комбинирования преимуществ обоих методов.
Для всесторонней оценки разработанного фреймворка была использована база данных QiuZhen-Bench, включающая 1054 математические задачи, специально разработанные для проверки пределов рассуждений больших языковых моделей (LLM). Данный набор данных представляет собой сложный тест, предназначенный для выявления слабых мест в логических выводах и способности LLM к решению задач, требующих глубокого понимания математических принципов. Использование QiuZhen-Bench позволило провести строгую количественную оценку эффективности фреймворка в условиях, приближенных к реальным сценариям применения LLM в области математики и логики.

Надёжность и Масштабируемость Подтверждены Практикой
Эксперименты, проведенные с использованием моделей GPT-5-mini и Qwen3-30B-A3B, наглядно демонстрируют эффективность предложенного фреймворка «Пессимистической Верификации» применительно к различным большим языковым моделям. Данный подход успешно протестирован на гетерогенном наборе LLM, подтверждая его универсальность и адаптивность. Результаты показывают, что фреймворк способен эффективно выявлять ошибки и оценивать надежность ответов, независимо от архитектуры или размера используемой модели, что делает его ценным инструментом для оценки и улучшения качества генерации текста в задачах искусственного интеллекта. Подобная совместимость с разными моделями открывает перспективы для широкого применения в различных областях, требующих высокой точности и надежности.
Исследования показали, что разработанный метод демонстрирует высокую эффективность в выявлении ошибок в решениях больших языковых моделей. Оценка проводилась на сложном наборе математических задач, включающем 1054 примера, и позволила добиться значительного улучшения показателя истинной отрицательной доли ($True Negative Rate$), что свидетельствует о высокой точности выявления неверных ответов. Более того, сбалансированные значения $F1$-меры подтверждают, что метод обеспечивает высокую производительность как в отношении точности, так и полноты обнаружения ошибок, что делает его надежным инструментом для оценки и верификации решений, генерируемых современными языковыми моделями.
Архитектура разработанной системы верификации, в отличие от многих существующих подходов, изначально ориентирована на масштабируемость. Это позволяет эффективно оценивать производительность всё более крупных и сложных языковых моделей, таких как GPT-5 и Qwen3, без снижения точности обнаружения ошибок. В процессе тестирования на наборе из 1054 сложных математических задач, система продемонстрировала стабильно высокие показатели, сохраняя сбалансированные метрики $F_1$ и высокую долю верноотрицательных результатов. Такая конструкция обеспечивает возможность расширения возможностей верификации в будущем, адаптируясь к развитию и усложнению моделей искусственного интеллекта без необходимости значительной переработки базовых алгоритмов.

Статья, исследующая методы пессимистической верификации для задач с открытым ответом в математике, закономерно вызывает усмешку. Авторы стремятся повысить выявление ошибок в больших языковых моделях, что, в сущности, означает признание их неизбежности. Этот подход, акцентирующий поиск ошибок вместо достижения консенсуса, прекрасно иллюстрирует простую истину: идеального кода не бывает. Как заметил Г.Х. Харди: «Математика — это наука о бесконечном», и, следовательно, о бесконечном количестве потенциальных ошибок. Верификация, даже самая «пессимистичная», лишь откладывает неизбежное столкновение с реальностью, где продакшен всегда найдёт способ доказать несостоятельность любой, даже самой элегантной теории.
Куда же дальше?
Представленные методы “пессимистической верификации” — наивные, последовательные и прогрессивные — лишь отсрочивают неизбежное. Каждая “революционная” модель, способная генерировать математические доказательства, рано или поздно столкнётся с тем, что продакшен найдет способ сломать даже самую элегантную теорию. Выявление ошибок, даже с приоритетом над достижением консенсуса, — это временная победа в бесконечной войне между абстракцией и реальностью.
Вопрос не в том, чтобы создать идеальный детектор ошибок, а в том, как смириться с их неминуемостью. Масштабируемость QiuZhen-Bench, безусловно, важна, но она лишь позволяет выявлять больше ошибок, а не предотвращать их появление. Будущие исследования, вероятно, сосредоточатся на автоматизации процесса “похоронов” моделей, то есть на разработке эффективных стратегий восстановления после сбоев, а не на их предотвращении.
Всё, что можно задеплоить — однажды упадёт. И пусть даже эта абстракция умирает красиво, с подробным отчётом об ошибках, это лишь иллюзия контроля. И всё же, в этом тщетном стремлении к надежности есть своя печальная красота.
Оригинал статьи: https://arxiv.org/pdf/2511.21522.pdf
Связаться с автором: https://www.linkedin.com/in/avetisyan/
Смотрите также:
- Анализ LINK: тенденции рынка криптовалют LINK
- Адаптация к угрозам: Непрерывное обучение для защиты смарт-контрактов
- Энергетические следы: Атаки и защита в мире электроники
- Безопасная связь: Оптимизация лучеформирования для генерации ключей и передачи данных
- Тяжелые кварки: от распада до структуры
- Эффективный расчет сложных систем: новый подход к квантовой химии
- Квантовые новости, 15 апреля 2025 года
- Квантовые Хроники: Квантовая Площадка Колорадо и Биткойн Вызов!
- Квантовая гонка разгоняется: мои горячие мнения! 🔥
- Прорыв в области квантовой физики под водой и в облаке: что на самом деле происходит?
2025-11-28 09:45