Автор: Денис Аветисян
В статье представлен инновационный алгоритм, позволяющий снизить артефакты при сжатии научных данных, не жертвуя при этом эффективностью.
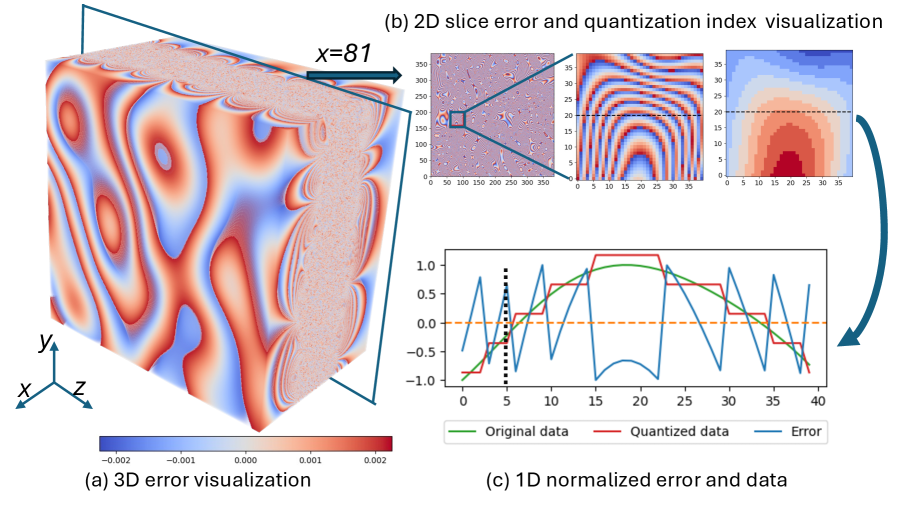
Метод использует квантование с учетом интерполяции для повышения качества сжатых научных данных и поддерживает параллельные вычисления.
Несмотря на растущую потребность в эффективном сжатии научных данных, методы, основанные на предварительной квантизации, часто страдают от потери качества данных при заданных пределах допустимой погрешности. В данной работе, посвященной проблеме ‘Mitigating Artifacts in Pre-quantization Based Scientific Data Compressors with Quantization-aware Interpolation’, исследуются артефакты, возникающие при использовании предварительной квантизации, и предлагается новый алгоритм для их смягчения. Предложенный подход использует интерполяцию с учетом квантования для повышения точности восстановленных данных без снижения производительности сжатия, а также реализован в параллельных вычислительных средах. Возможно ли дальнейшее улучшение качества сжатых научных данных и расширение областей применения предложенного алгоритма в высокопроизводительных вычислениях?
Предел Потери: Диалектика Сжатия и Искажения
Повсеместное использование сжатия с потерями, несмотря на его широкую распространенность, неизбежно связано с появлением артефактов и искажений в восстановленных данных. Стремление к более высоким степеням сжатия, позволяющим экономить место для хранения и пропускную способность передачи, зачастую приводит к необратимой утрате информации. Эти искажения могут проявляться в виде блочности изображений, размытости звука или ошибок в структуре данных, что особенно критично для приложений, требующих высокой точности и достоверности. Чем сильнее сжатие, тем заметнее становятся эти артефакты, создавая компромисс между размером файла и качеством восстановленных данных, который необходимо тщательно учитывать при выборе метода сжатия.
Традиционные методы сжатия данных, несмотря на свою повсеместность, сталкиваются со значительными трудностями при попытке достичь высокого коэффициента сжатия без существенной потери качества. По мере увеличения объемов данных эта проблема усугубляется: алгоритмы, эффективно работающие с небольшими файлами, демонстрируют снижение производительности и увеличение артефактов при обработке крупных наборов информации. Это связано с тем, что существующие подходы часто основаны на упрощенных моделях данных и не способны адекватно учитывать сложные зависимости внутри больших массивов, что приводит к необратимой потере деталей и искажению информации. В результате, баланс между степенью сжатия и сохранением точности данных становится все более хрупким, требуя разработки новых, более совершенных алгоритмов.
Существующие методы сжатия данных, несмотря на широкое распространение, часто не обеспечивают гарантий в отношении допустимых погрешностей. Это означает, что степень искажения информации при сжатии может быть непредсказуемой и варьироваться в широких пределах. В результате, восстановленные данные могут содержать артефакты или отклонения от оригинала, которые критичны для определенных приложений, таких как медицинская визуализация или научные исследования. Отсутствие четких границ ошибок делает сложным прогнозирование качества восстановленных данных и может приводить к нежелательным последствиям, особенно при работе с большими объемами информации, где даже незначительные искажения могут накапливаться и приводить к серьезным проблемам. Таким образом, необходимость разработки методов, обеспечивающих контролируемую потерю данных и предсказуемые границы ошибок, становится все более актуальной.
Появление всё более масштабных наборов данных выявляет ограничения традиционных методов сжатия с потерями, что обуславливает потребность в инновационных подходах. В отличие от существующих алгоритмов, стремящихся лишь к максимальной степени сжатия, современные исследования направлены на разработку техник, способных обеспечивать высокую степень компрессии, одновременно гарантируя контролируемую деградацию данных. Такой подход позволяет предсказуемо ограничивать потери информации, что критически важно для приложений, где точность данных имеет первостепенное значение, например, в медицинских изображениях или научных симуляциях. Вместо неконтролируемого снижения качества, новые методы стремятся к точному балансу между объёмом сжатых данных и допустимым уровнем искажений, открывая возможности для эффективного хранения и передачи информации без критических потерь.
Предварительная Квантизация: Путь к Параллельной Обработке
Предварительная квантизация играет важную роль в повышении параллелизма сжатия за счет снижения последовательных зависимостей в данных. Традиционные алгоритмы сжатия часто обрабатывают данные последовательно, что ограничивает возможности распараллеливания. Предварительная квантизация, путем применения линейного масштабирования перед кодированием, позволяет разделить данные на независимые блоки, которые могут быть обработаны параллельно. Это особенно важно для GPU-ускоренных алгоритмов сжатия, где высокая степень параллелизма критически важна для достижения максимальной производительности и минимизации узких мест. Снижение зависимостей между данными позволяет эффективно использовать вычислительные ресурсы GPU и значительно сократить время сжатия.
Применение линейного масштабирования квантования перед кодированием позволяет добиться существенного прироста скорости сжатия данных. Этот подход предполагает предварительное преобразование значений данных таким образом, чтобы уменьшить разброс и динамический диапазон, что упрощает последующую работу алгоритмов сжатия. Уменьшение динамического диапазона снижает вычислительную сложность операций кодирования, позволяя выполнять их параллельно на графических процессорах (GPU) с большей эффективностью. По сути, предварительное квантование уменьшает объем вычислений, необходимых для кодирования каждого образца данных, что приводит к увеличению пропускной способности и снижению задержек при сжатии.
Предварительная квантизация данных подготавливает их к эффективной GPU-компрессии, что позволяет максимизировать пропускную способность и минимизировать узкие места. GPU, благодаря своей архитектуре, особенно хорошо справляются с параллельной обработкой, но требуют структурированных и унифицированных данных. Предварительная квантизация приводит данные к такому виду, что GPU может выполнять операции сжатия параллельно над большими блоками данных, избегая последовательных зависимостей. Это существенно увеличивает скорость обработки по сравнению с традиционными методами, где операции выполняются последовательно над каждым элементом данных. Увеличение пропускной способности достигается за счет более эффективного использования вычислительных ресурсов GPU и сокращения времени, затрачиваемого на передачу данных между памятью и процессором.
Ряд современных компрессоров, включая cuSZ, FZ-GPU и cuSZp, успешно внедрили предварительную квантизацию в свои основные алгоритмы. cuSZ использует предварительную квантизацию для улучшения параллельной обработки данных, что приводит к повышению скорости сжатия. FZ-GPU также интегрировал этот подход для оптимизации производительности на графических процессорах. cuSZp, являясь улучшенной версией cuSZ, расширяет возможности предварительной квантизации, обеспечивая еще более высокую эффективность сжатия и снижение зависимости от последовательной обработки данных. Внедрение предварительной квантизации позволяет этим компрессорам более эффективно использовать возможности параллельных вычислений, особенно на GPU.
Смягчение Артефактов: Восстановление Целостности Данных
Несмотря на постоянное развитие алгоритмов сжатия данных, артефакты остаются неизбежной проблемой в схемах с потерями. Это связано с тем, что потеря информации при сжатии приводит к искажениям, которые проявляются в виде визуальных дефектов или неточностей в восстановленных данных. Даже современные кодеки, такие как JPEG, JPEG 2000 и HEVC, не могут полностью избежать появления артефактов, особенно при высоких степенях сжатия. Проблема усугубляется при обработке научных данных, где даже незначительные искажения могут привести к серьезным ошибкам в результатах анализа и моделирования. Различные методы, такие как фильтрация и преобразование расстояний, применяются для смягчения этих артефактов, однако полное их устранение остается сложной задачей.
Для снижения искажений, возникающих при использовании алгоритмов с потерями, применяются различные методы фильтрации и преобразования расстояний. Фильтрация Гаусса, равномерная фильтрация и фильтрация Винера эффективно сглаживают артефакты, уменьшая высокочастотные шумы, вызванные квантованием. Преобразование расстояний на основе евклидовой метрики позволяет оценить близость пикселей и корректировать значения на основе их окружения. Комбинирование этих методов позволяет добиться значительного улучшения качества восстановленных данных, минимизируя визуальные дефекты и повышая точность анализа.
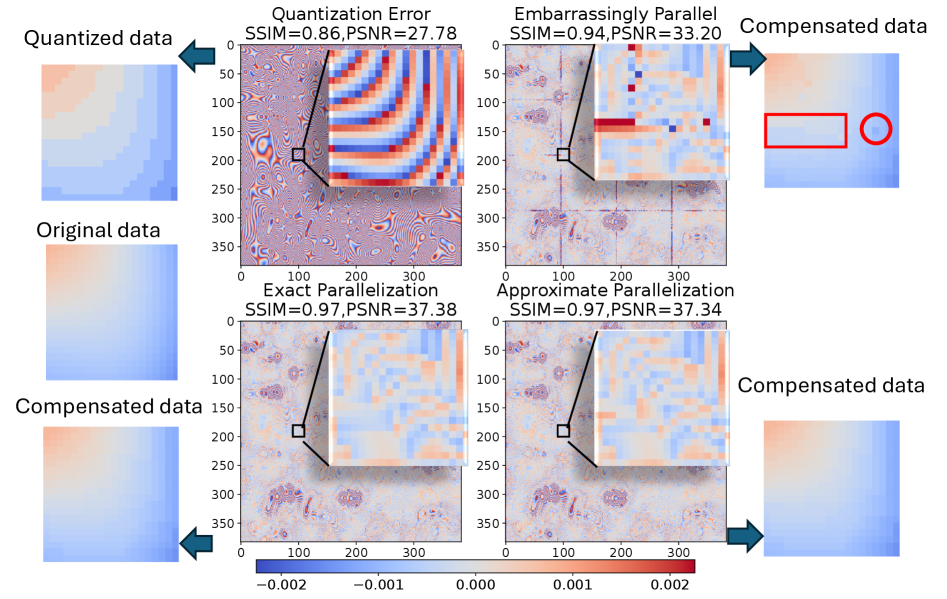
Предложенный метод интерполяции с учетом квантования демонстрирует значительное снижение артефактов в декомпрессированных научных данных. В ходе тестирования зафиксировано увеличение показателя Structural Similarity Index Measure (SSIM) до 108.33% по сравнению с результатами, полученными без применения данного метода. Данное улучшение SSIM указывает на существенное повышение структурного сходства между исходными и декомпрессированными данными, что свидетельствует об эффективности метода в восстановлении информации, потерянной в процессе квантования и сжатия с потерями.
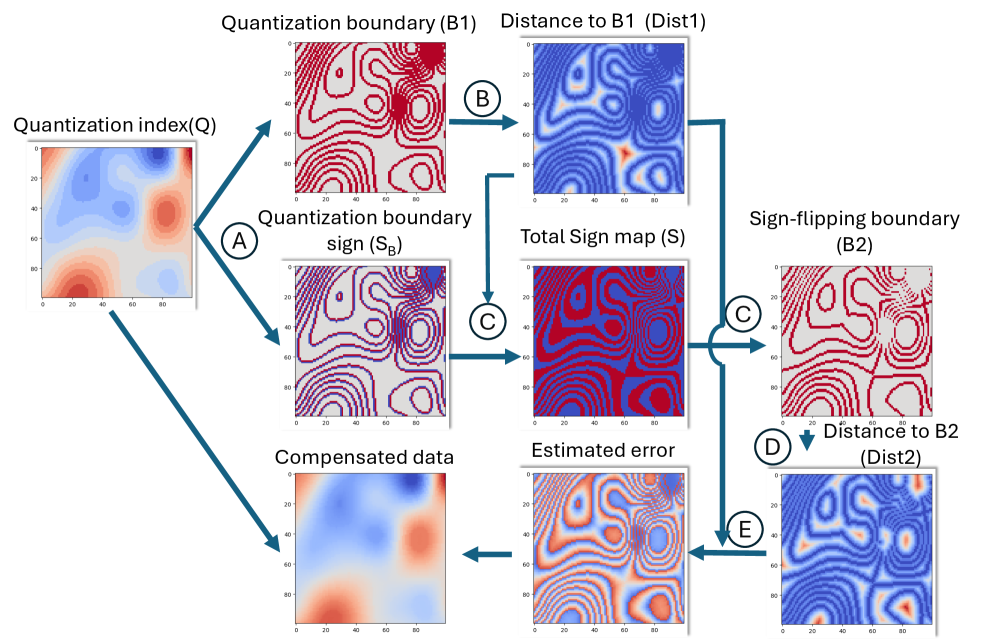
Эффективность методов снижения артефактов сжатия напрямую зависит от понимания особенностей процесса квантования, а именно — знака и величины возникающих ошибок. Для точного анализа и последующей коррекции используются карты индекса квантования (Quantization Index) и знаков (Sign Map). Карта индекса квантования отображает степень округления каждого значения данных в процессе квантования, позволяя выявить области с наибольшими потерями информации. В свою очередь, карта знаков фиксирует знак ошибки квантования (положительная или отрицательная), что позволяет более точно восстановить исходные данные, учитывая направление искажений. Комбинированное использование этих карт позволяет эффективно моделировать и минимизировать артефакты, возникающие при потере информации в процессе сжатия.
Параллелизация процессов снижения артефактов, достигаемая посредством использования OpenMP и MPI, позволяет существенно повысить производительность и масштабируемость алгоритмов восстановления данных. OpenMP обеспечивает параллелизм на уровне потоков внутри одного узла, эффективно используя многоядерные процессоры для одновременной обработки различных участков данных. MPI, в свою очередь, обеспечивает распределенную обработку данных между несколькими узлами вычислительной сети, что особенно важно при работе с большими объемами данных и сложных вычислениях. Комбинированное использование OpenMP и MPI позволяет добиться оптимальной производительности как на локальных, так и на кластерных вычислительных системах, что критически важно для обработки больших объемов научных данных и обеспечения высокой скорости восстановления информации после сжатия с потерями.
Оптимизированные Реализации и Перспективы Развития
Современные компрессоры, такие как cuSZp2, ярко демонстрируют эффективность синергии предварительной квантизации с оптимизированным доступом к памяти и методами предсказания, в частности, алгоритмом Lorenzo Prediction. Данный подход позволяет значительно повысить степень сжатия данных за счет минимизации избыточности и более эффективного использования аппаратных ресурсов. Предварительная квантизация уменьшает объем информации, подлежащей обработке, в то время как оптимизированный доступ к памяти и Lorenzo Prediction снижают вычислительные затраты и повышают скорость сжатия. В результате, достигается не только улучшенное соотношение компрессии, но и существенное увеличение пропускной способности, что особенно важно для современных высокопроизводительных систем обработки данных.
Предложенный подход демонстрирует значительное повышение эффективности сжатия данных. В ходе тестирования было зафиксировано увеличение коэффициента сжатия на 1,17x для алгоритма cuSZ и на 1,34x для cuSZp2, при сохранении сопоставимого уровня структурного подобия (SSIM). Это указывает на то, что разработанная методика позволяет достичь более высокой степени уменьшения размера данных без ощутимой потери качества изображения, что особенно важно для приложений, требующих высокой производительности и эффективного использования памяти.
В современных системах сжатия центральную роль играют реализации на базе графических процессоров (GPU). Это обусловлено их архитектурой, позволяющей эффективно выполнять параллельные вычисления, необходимые для обработки больших объемов данных. В отличие от традиционных центральных процессоров, GPU способны одновременно обрабатывать множество потоков данных, значительно ускоряя процесс сжатия и распаковки. Благодаря этому, GPU-ускоренные алгоритмы сжатия демонстрируют высокую пропускную способность и масштабируемость, что особенно важно при работе с изображениями высокого разрешения, видеопотоками и другими типами больших данных. Переход к GPU-реализациям стал ключевым фактором в развитии современных систем сжатия, позволяя эффективно использовать вычислительные ресурсы и удовлетворять растущие требования к скорости и эффективности обработки данных.
Исследование демонстрирует значительный прирост эффективности предложенного метода компрессии при увеличении степени распараллеливания. При использовании приблизительной параллелизации с 256 рангами, достигается эффективность в 85.0% по сравнению с базовым вариантом, использующим 64 ранга. Данный результат свидетельствует о высокой масштабируемости метода, что позволяет эффективно использовать ресурсы современных многоядерных графических процессоров для обработки больших объемов данных. Подобная масштабируемость является ключевым фактором для практического применения в задачах, требующих высокой пропускной способности и минимальной задержки, например, при обработке видеопотоков или хранении больших научных массивов данных.
В дальнейших исследованиях планируется разработка адаптивных схем квантования, способных динамически изменять параметры сжатия в зависимости от характеристик данных. Такой подход позволит значительно повысить эффективность компрессии, поскольку позволит более точно подстраиваться под особенности каждого конкретного фрагмента информации. Вместо использования фиксированных параметров квантования, система сможет анализировать локальные свойства данных — например, уровень детализации, контрастность или наличие определенных текстур — и соответствующим образом корректировать степень квантования. Это особенно важно для изображений и видео, где разные области могут требовать разной степени сжатия для достижения оптимального баланса между размером файла и визуальным качеством. Реализация таких адаптивных схем требует разработки эффективных алгоритмов анализа данных и динамического управления параметрами квантования, что представляет собой перспективное направление для будущих исследований в области сжатия данных.
Постоянное стремление к повышению эффективности сжатия данных неизбежно толкает границы как алгоритмических разработок, так и аппаратного ускорения. Исследования в этой области демонстрируют, что дальнейшее совершенствование методов сжатия требует не только инновационных алгоритмов, способных более эффективно кодировать информацию, но и специализированного аппаратного обеспечения, оптимизированного для выполнения этих алгоритмов с максимальной производительностью. Ожидается, что будущие разработки будут направлены на создание систем, в которых алгоритмы и аппаратная часть будут тесно интегрированы, обеспечивая беспрецедентные уровни сжатия и скорости обработки данных, что критически важно для таких областей, как хранение больших данных, потоковое видео и научные вычисления. В результате, эта синергия между программным и аппаратным обеспечением продолжит стимулировать прогресс в области обработки и хранения информации.
Исследование, представленное в данной работе, демонстрирует, что попытки построить идеальные системы сжатия научных данных обречены на неудачу. Авторы предлагают не устранять артефакты сжатия, а предвидеть их появление и смягчать последствия, используя интерполяцию с учетом квантования. Такой подход соответствует философии, согласно которой системы — это не инструменты, а экосистемы, требующие постоянной адаптации. Как однажды заметил Пол Эрдёш: «В математике нет ничего, кроме красоты и простоты». Сжатие научных данных, подобно математике, требует элегантности и признания неизбежности ошибок. Предотвращение артефактов сжатия, основанное на предвидении и смягчении, а не на полном их устранении, подчеркивает, что настоящая устойчивость начинается там, где кончается уверенность в идеальной точности.
Что дальше?
Представленные методы, безусловно, смягчают артефакты сжатия в научных данных, но не следует полагать, будто ошибка полностью побеждена. Скорее, она лишь трансформируется, перетекая из видимых искажений в более тонкие, скрытые погрешности. Каждый компромисс, застывший в алгоритме интерполяции, — это пророчество о будущем сбое, который проявится в неожиданный момент, когда данные будут использованы для критически важных вычислений. Технологии сменяются, зависимости остаются.
Настоящим вызовом является не столько совершенствование алгоритмов сжатия, сколько разработка систем, способных оценивать и учитывать неопределенность, присущую данным. Необходимо двигаться от концепции «ошибочно-свободного» сжатия к концепции «ошибочно-ограниченного» представления, где погрешность является неотъемлемой частью данных, а не досадным побочным эффектом. Параллельные вычисления, безусловно, облегчают задачу, но не решают её.
В конечном итоге, системы — это не инструменты, а экосистемы. Их нельзя построить, только вырастить. Следующим шагом должно стать изучение динамических алгоритмов сжатия, способных адаптироваться к изменяющимся характеристикам данных и минимизировать ошибку в реальном времени. И, возможно, тогда станет ясно, что истинная ценность научных данных заключается не в их точности, а в их способности порождать новые вопросы.
Оригинал статьи: https://arxiv.org/pdf/2602.20097.pdf
Связаться с автором: https://www.linkedin.com/in/avetisyan/
Смотрите также:
- Безопасная связь: Оптимизация лучеформирования для генерации ключей и передачи данных
- Тяжелые кварки: от распада до структуры
- Адаптация к угрозам: Непрерывное обучение для защиты смарт-контрактов
- Квантовые новости, 15 апреля 2025 года
- Квантовые Хроники: Квантовая Площадка Колорадо и Биткойн Вызов!
- Квантовая гонка разгоняется: мои горячие мнения! 🔥
- Прорыв в области квантовой физики под водой и в облаке: что на самом деле происходит?
- Квантовый Кофе-Брейк: Давайте окунемся в последние разработки! ☕✨
- Квантовая Хиперрама: От Музыкальных Спектаклей на Капитолийском Холме до Всезвездного Шоу
- Квантовый апартеид: Не закрываем ли мы ворота в будущее?
2026-02-25 01:43